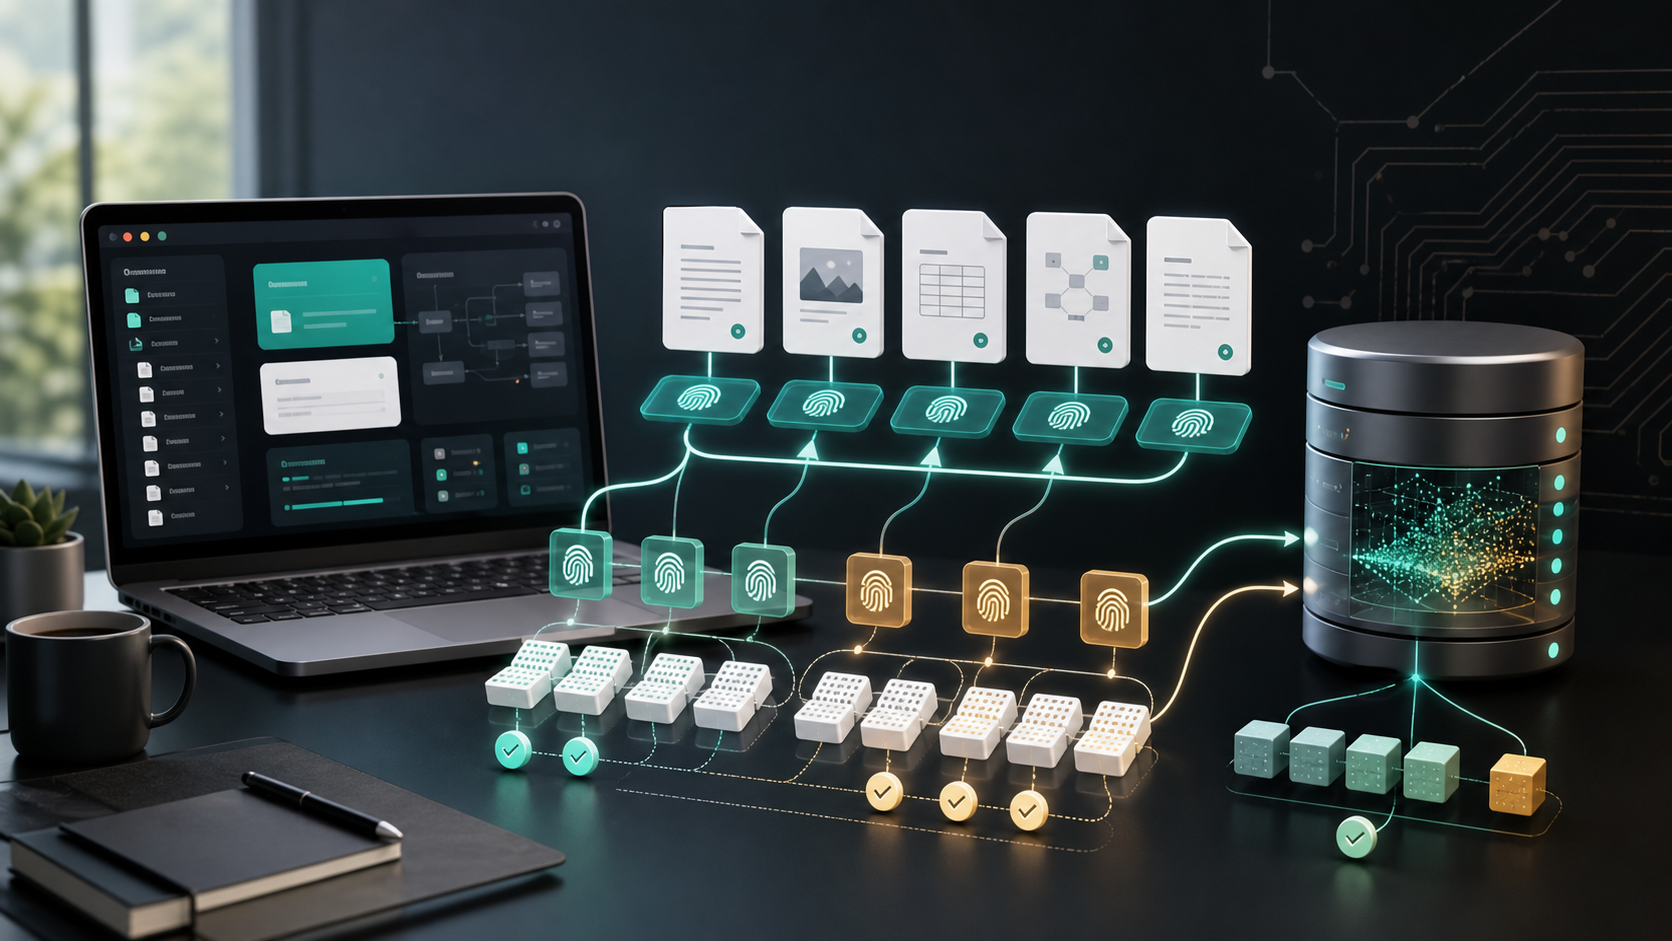
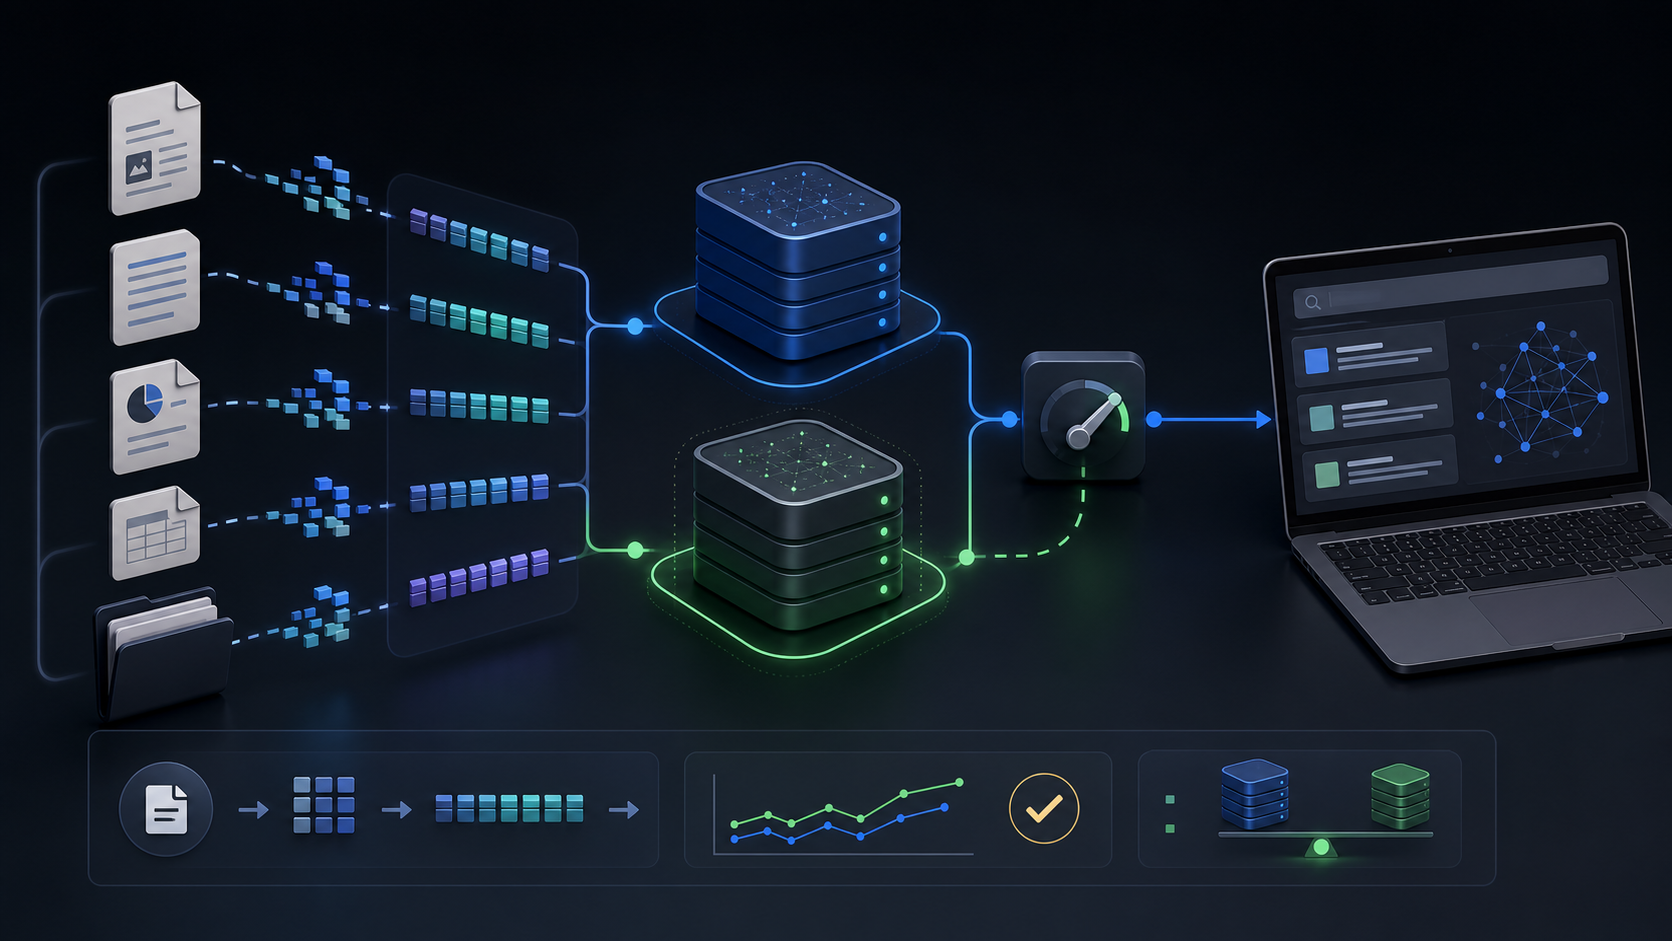
给 RAG 增量导入做去重时,我会先把文件指纹和 chunk 指纹拆开 2026-08-03 项目实战 AI 应用开发 / RAG / 自动化 / 工作流 / TypeScript / 工程实践 一次桌面端知识库增量导入复盘:用文件指纹判断入口变化,用 chunk 指纹控制嵌入复用,再用向量库 payload 做可追踪对账。 25 | 0
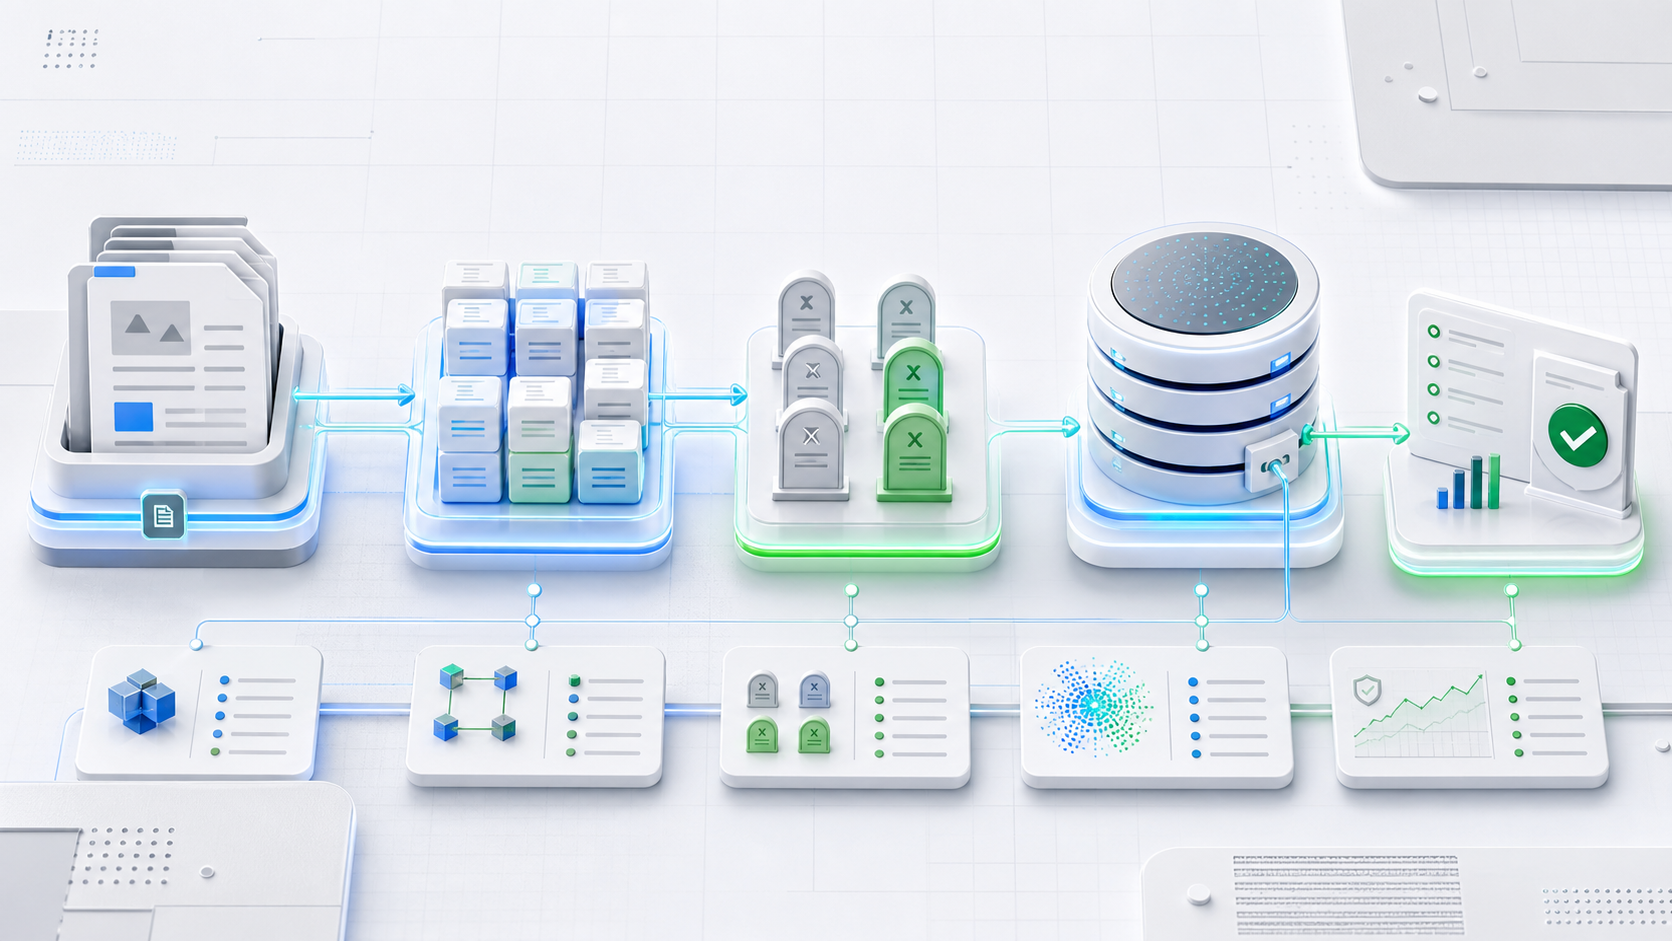
给 RAG 知识库做删除同步时,我会先把墓碑表和索引对账拆出来 2026-07-02 项目实战 AI 应用开发 / RAG / Agent / 自动化 / 工作流 / 工程实践 一篇 RAG 知识库删除同步的项目复盘:把源文档删除、chunk 版本、向量库删除、重试队列和索引对账拆成可追踪链路,减少旧知识块被继续召回的风险。 11 | 0
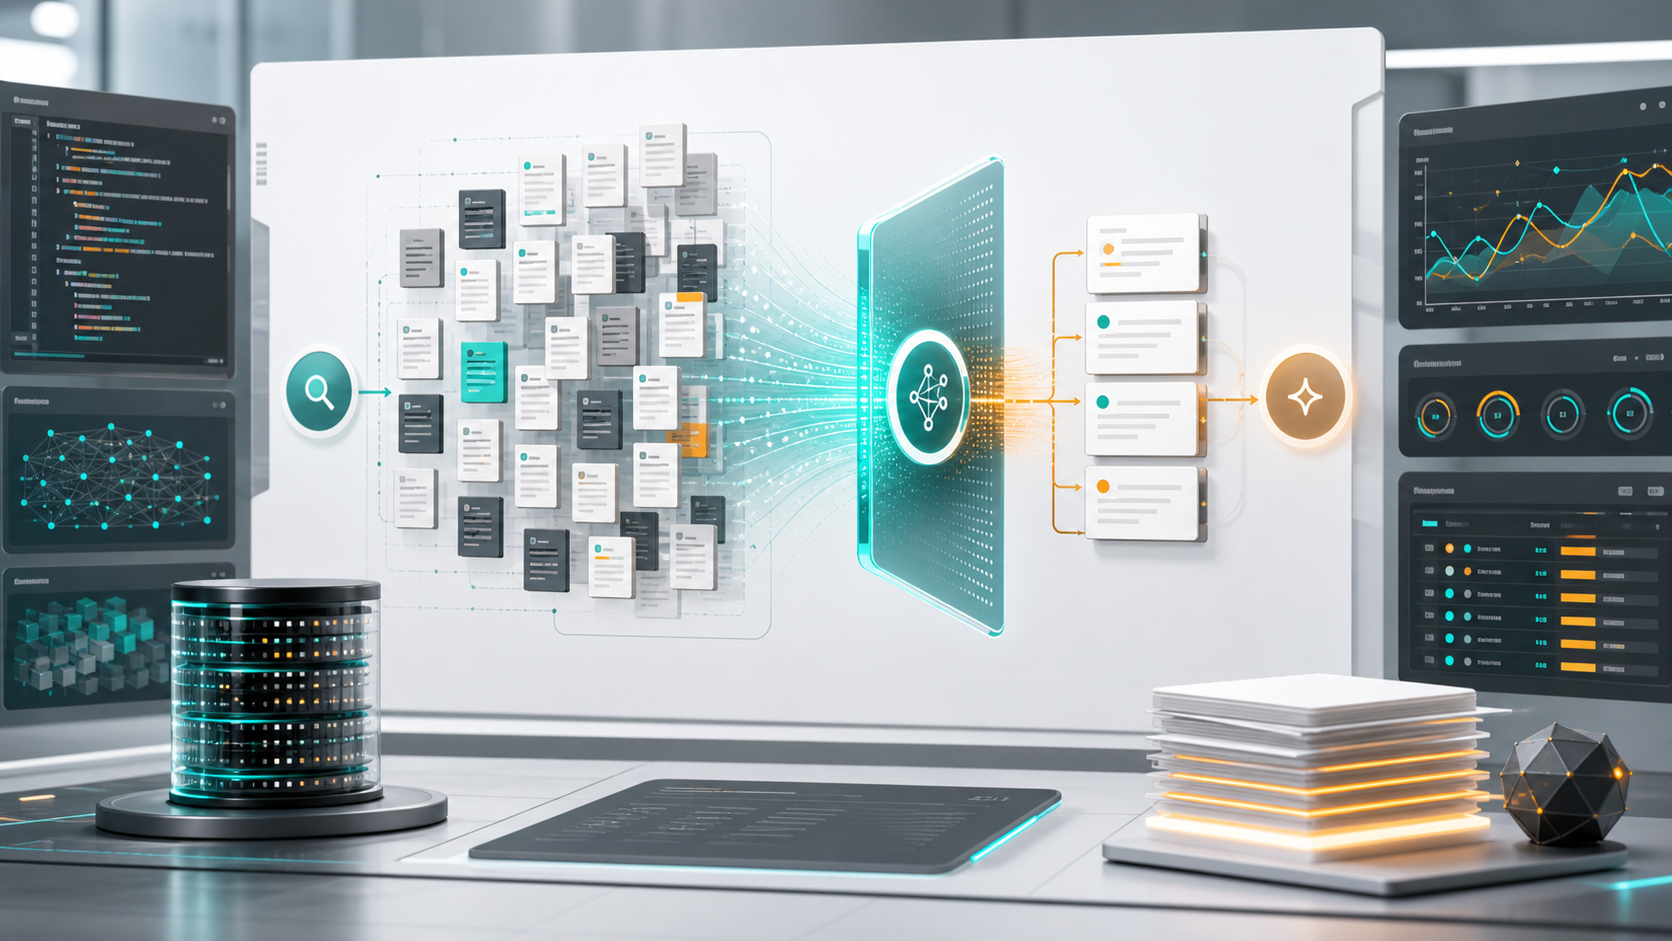
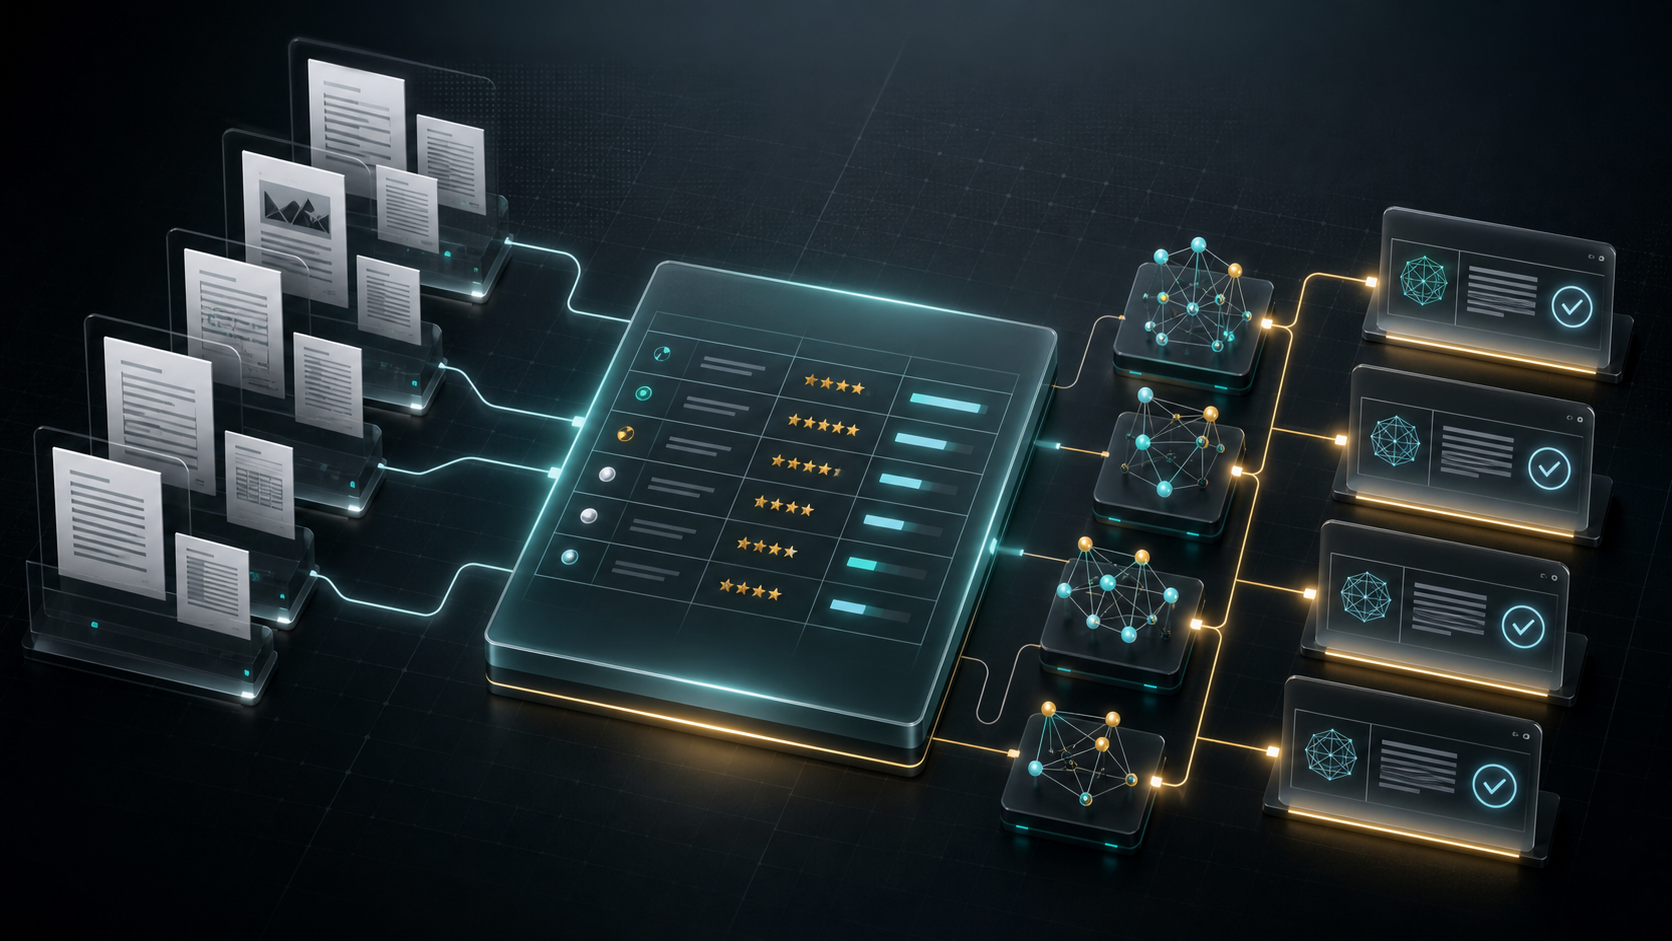
给 RAG 检索加重排前,我会先把召回池和证据账本拆开 2026-07-01 2026-07-01 项目实战 AI 应用开发 / RAG / Agent / 自动化 / 工作流 / 工程实践 一篇 RAG 检索重排上线复盘:把第一阶段召回池、rerank 分数、chunk 证据、评测指标和回滚开关拆成可追踪链路,减少答案看似变准但无法解释的风险。 13 | 0
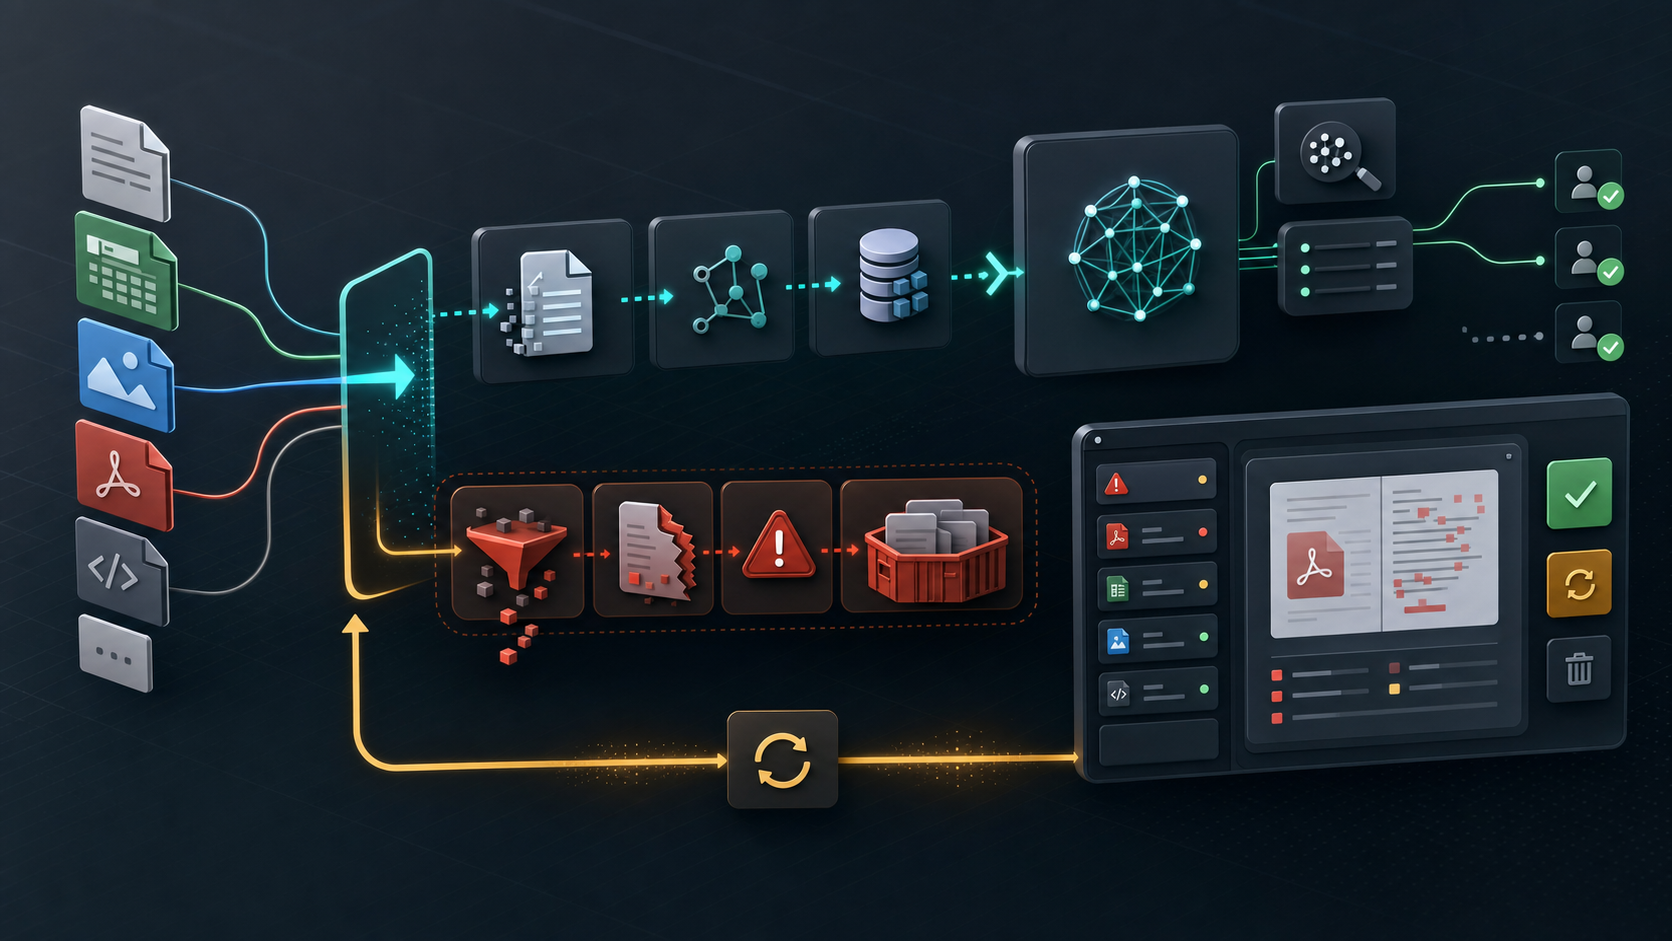
RAG 文档解析失败时,我会先建隔离队列和复核台 2026-06-16 项目实战 AI 应用开发 / RAG / 自动化 / 工作流 / TypeScript / 工程实践 一次 RAG 文档导入链路复盘:把解析失败从后台错误变成可分类、可复核、可重试、可追踪的隔离队列。 9 | 0
给 RAG 答案做引用证据卡时,我会先把 chunk 版本存下来 2026-06-10 项目实战 AI 应用开发 / RAG / 前端工程 / 工作流 / 工程实践 一次 RAG 答案可核验改造复盘:把命中 chunk、向量版本、引用片段和前端证据卡绑定,减少答非所问后的排查成本。 18 | 0
给 RAG 检索调参前,我会先建一组可回归问题集 2026-06-05 项目实战 AI 应用开发 / RAG / 自动化 / 工作流 / TypeScript / 工程实践 一次 RAG 质量排查复盘:先把高频问题、期望证据 chunk 和评测指标固化成小型 golden set,再用离线实验比较检索策略和提示词改动。 10 | 0
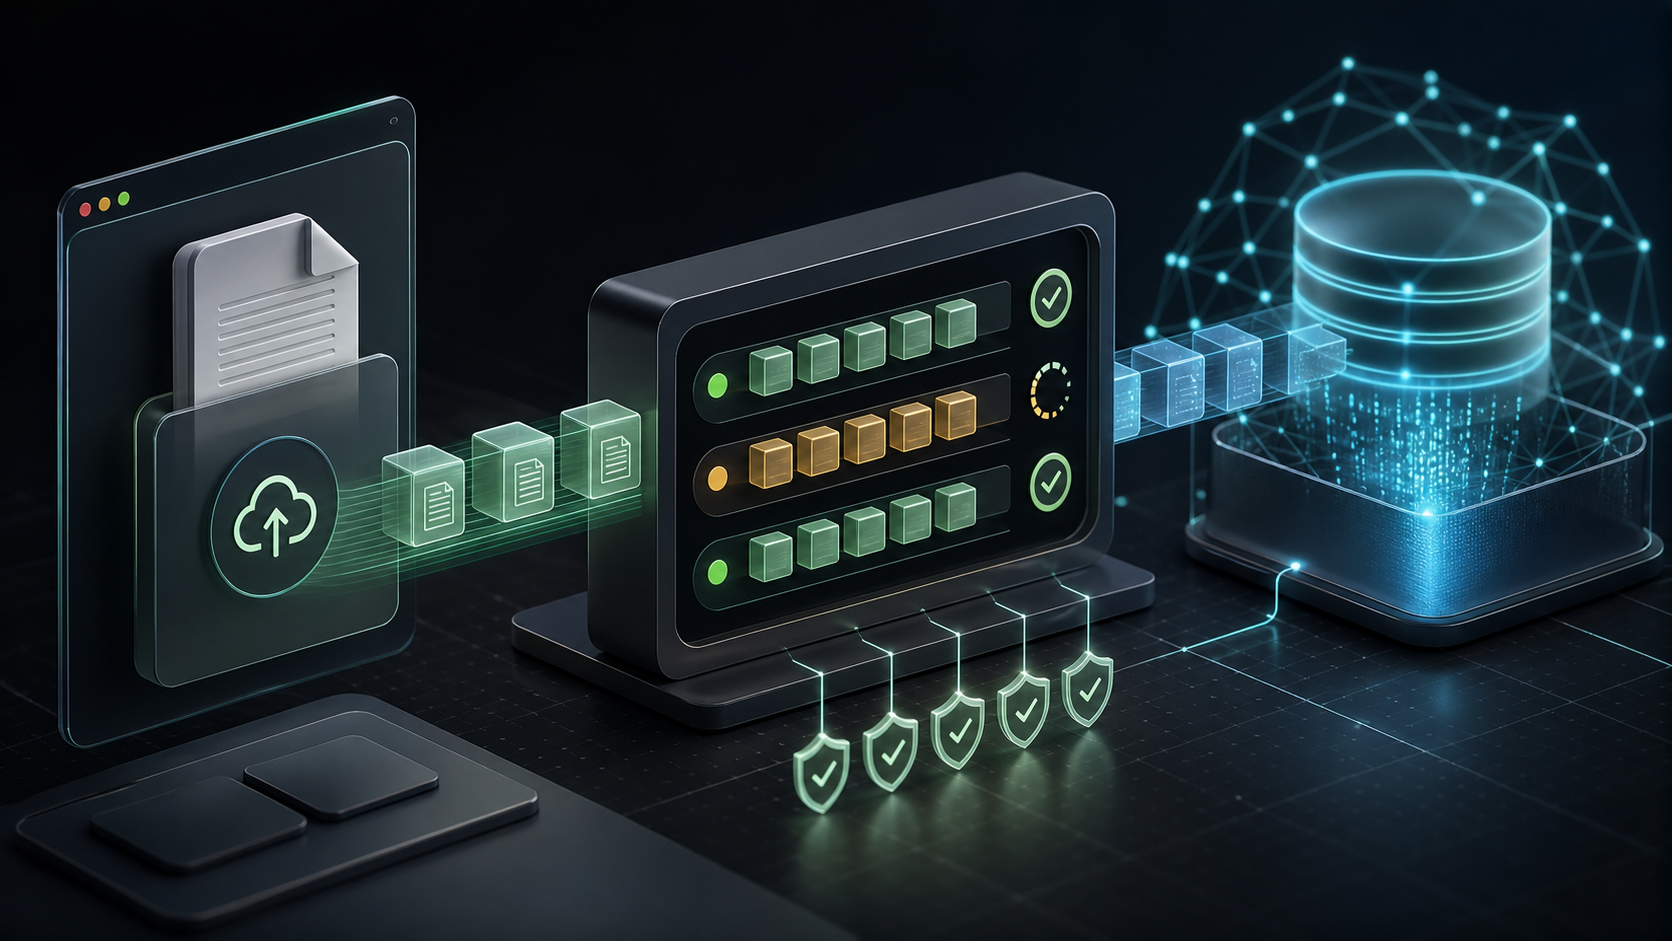
给 RAG 导入大文件前,我会先把上传队列做成可恢复状态机 2026-06-03 项目实战 RAG / 前端工程 / 自动化 / 工作流 / TypeScript / 工程实践 一次 RAG 批量导入的项目复盘:在切分和入库之前,先把浏览器端上传队列、校验、暂停恢复和失败重试做成可审查的状态机。 11 | 0
RAG 知识库重建时,我会先做一条可回滚的影子索引 2026-05-23 项目实战 AI 应用开发 / RAG / 自动化 / 工作流 / TypeScript / 工程实践 把文档切分、向量写入、检索校验和别名切换拆成可恢复步骤,可以减少线上 RAG 重建时的脏数据和停机风险。 20 | 0
Electron 打包后本地知识库总掉路径,我把 userData、sessionData 和 resources 拆成了三层 2026-05-19 2026-05-19 项目实战 AI 应用开发 / Electron / RAG / TypeScript / 工程实践 一次桌面端知识库应用的打包复盘,核心是把运行数据、浏览器缓存和只读资源彻底分层,减少升级后丢路径、数据库锁死和缓存污染。 14 | 0
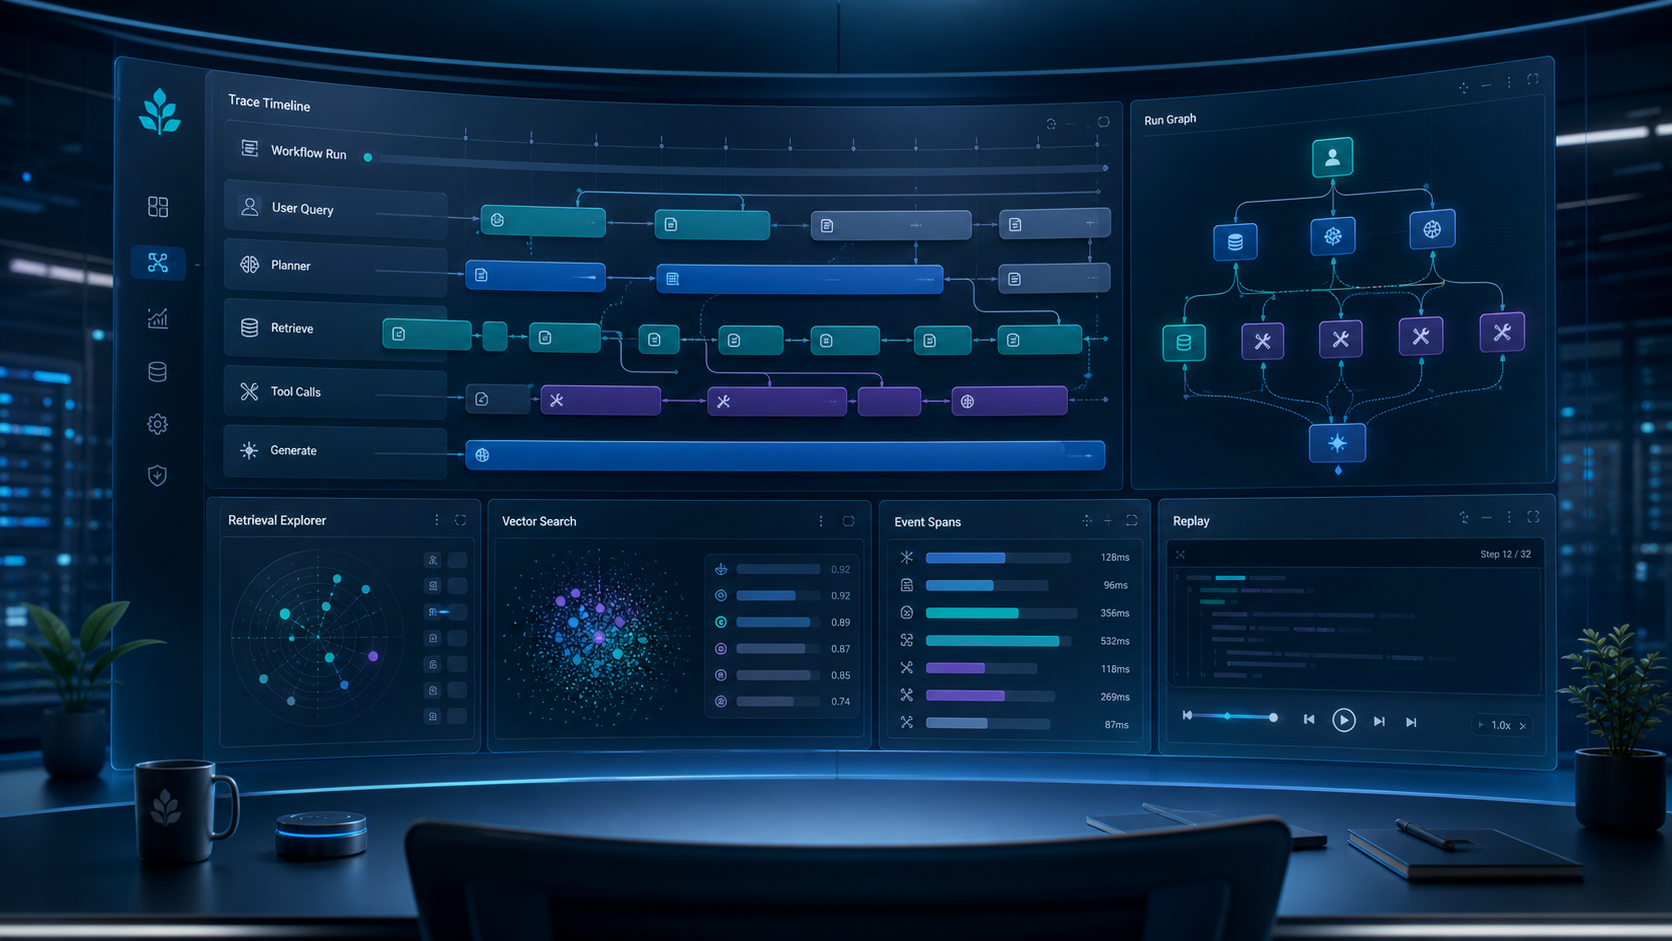
我给 RAG + Agent 工作流补了一条可回放 Trace,排障速度快了很多 2026-05-18 技术分享 AI 应用开发 / RAG / Agent / 自动化 / 工作流 / 工程实践 一次 RAG 与 Agent 联调链路的工程复盘,核心目标是把检索、工具调用和前端反馈串进同一条可回放 trace,缩短定位问题的往返时间。 15 | 0