
给 RAG 增量导入做去重时,我会先把文件指纹和 chunk 指纹拆开
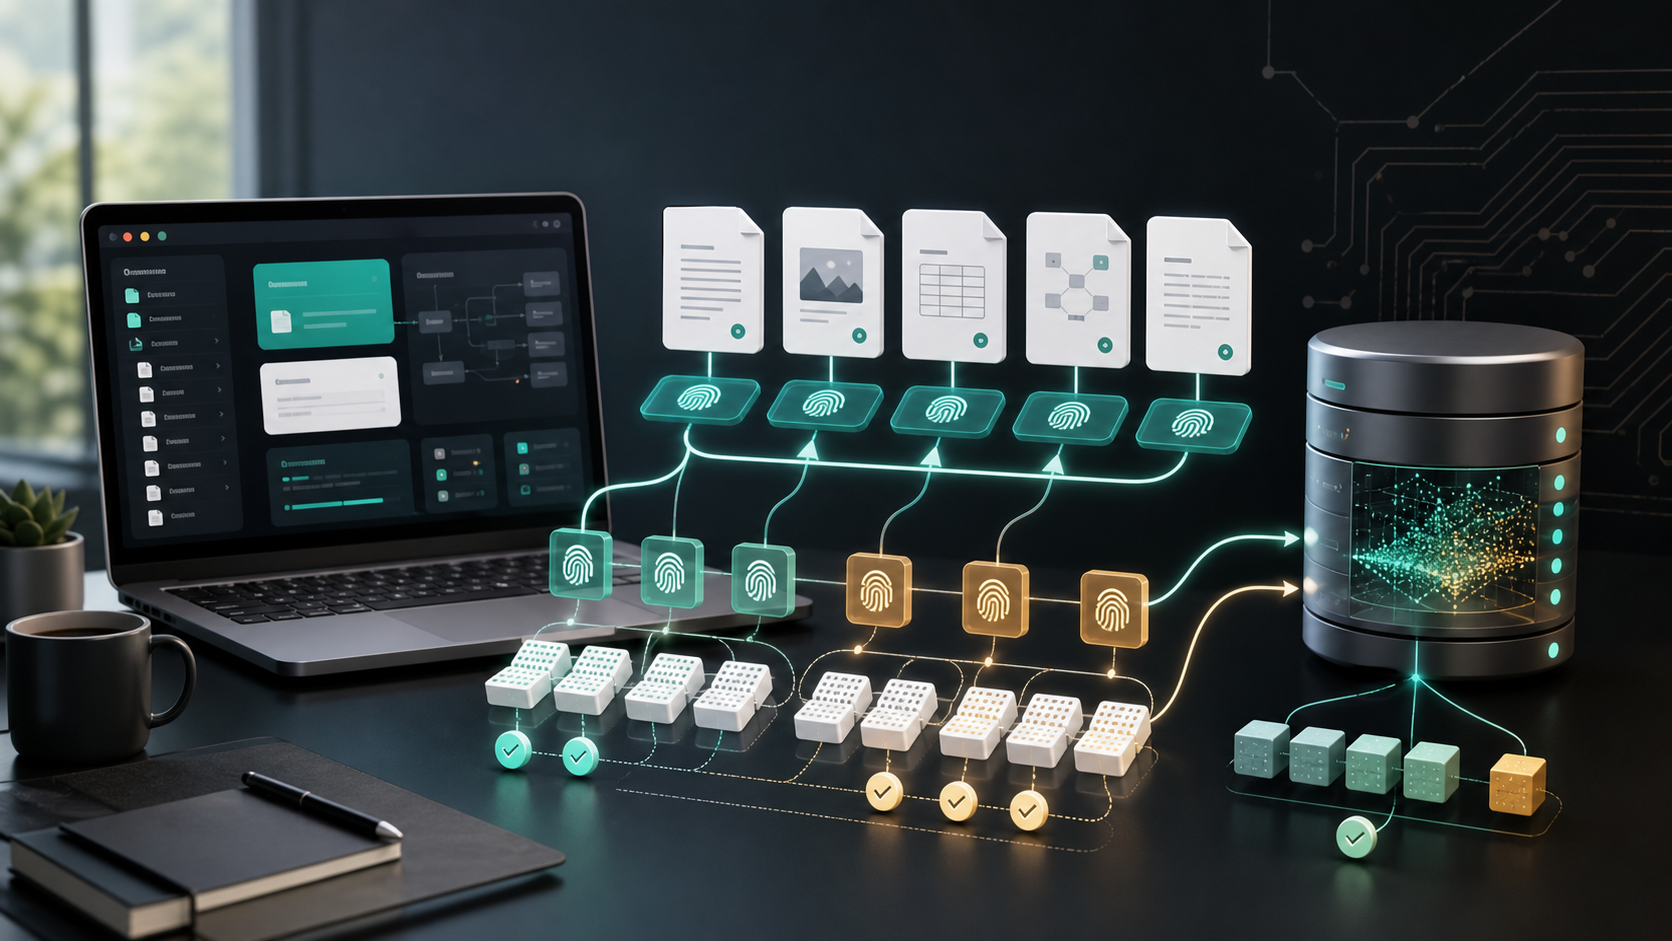
最近给一个 Electron 桌面端知识库做增量导入时,我又踩到一个老坑:用户只是改了文档里一小段话,后台却把整份文件重新解析、切片、embedding、写入向量库。小库看起来没问题,文件一多就会出现两个副作用:导入队列长期占着 CPU,检索结果里还会短暂混入旧 chunk 和新 chunk。
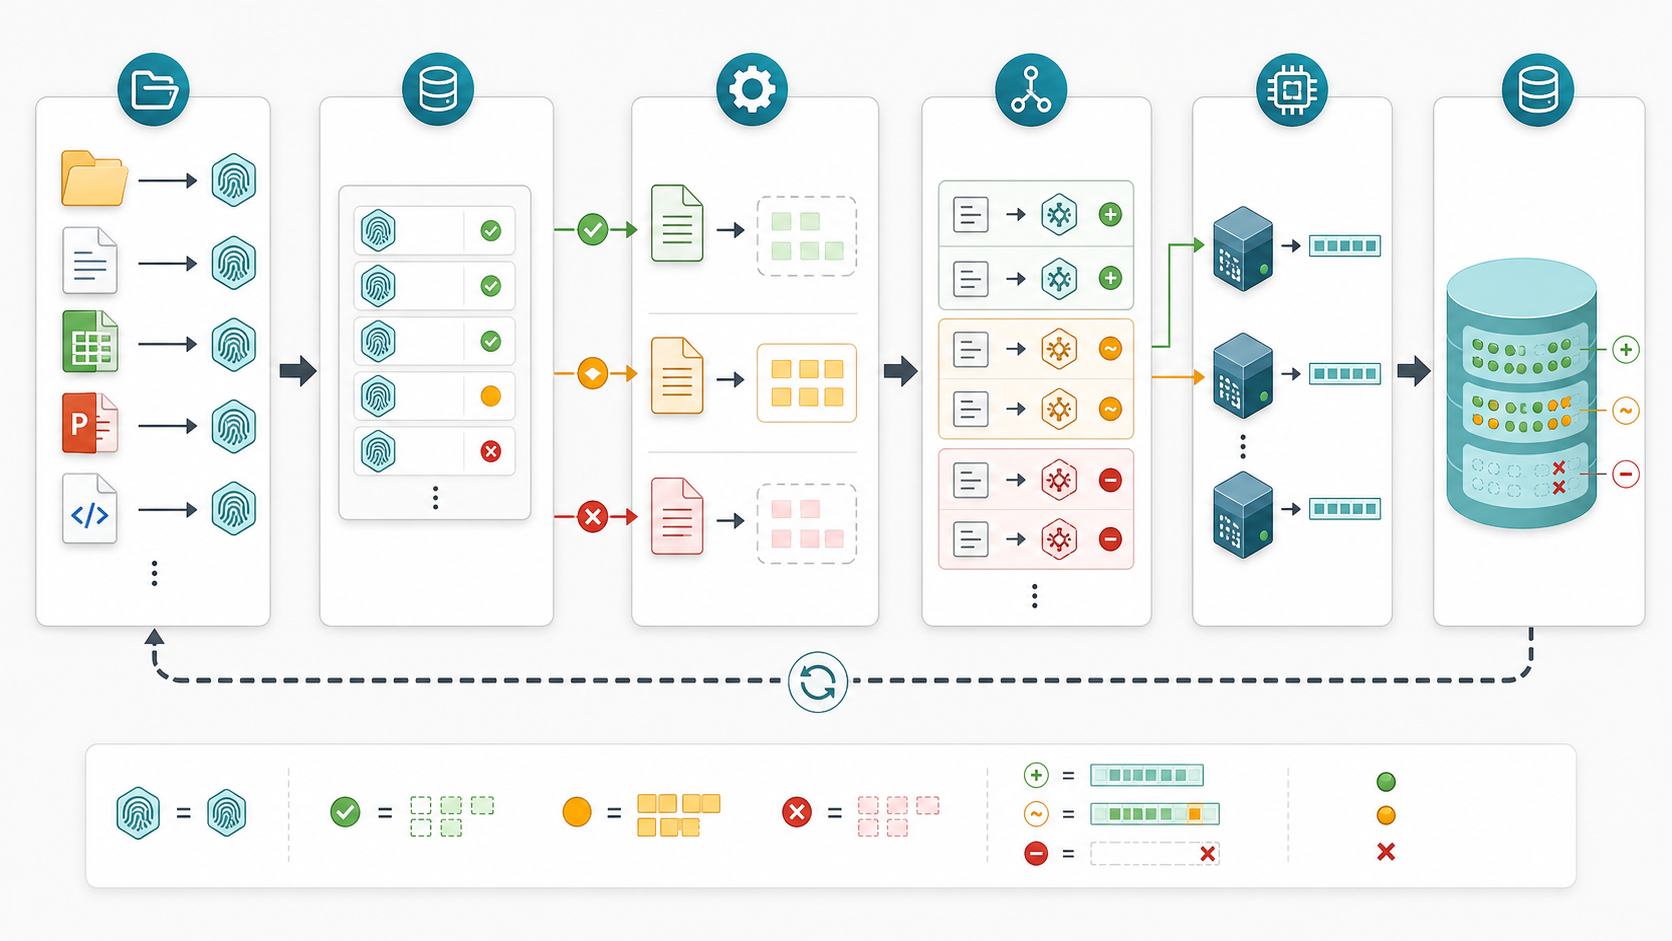
原创示意图:文件级指纹决定是否解析,chunk 级指纹决定是否重新 embedding,向量库 payload 用于过滤、删除和对账。 来源:Codex image generation
问题背景
一开始我用 mtime + size 作为是否重建的判断。这个方案便宜,但在网盘同步、批量导出、格式转换后很容易失真。同一份内容可能变了时间戳,不同内容也可能碰巧保持相近大小。后来我改成给原始文件做 SHA-256,文件级 hash 负责回答一个问题:这份输入有没有变化。
但 RAG 导入还有第二层问题。文件变化不代表所有 chunk 都要重新 embedding。LlamaIndex 的 IngestionPipeline 文档提到,node 和 transformation 的组合可以被 hash 并缓存,后续相同数据可以复用结果。这个思路给我的启发是,导入链路需要把输入层和产物层分开记录,文件指纹只能决定是否进入解析,chunk 指纹才决定是否进入 embedding 队列。
踩坑和关键难点
第一个难点是 hash 的对象要稳定。原始文件 hash 用来发现外部输入变化,解析后的正文 hash 用来发现解析器输出变化,chunk hash 则必须包含 doc_id、规范化文本、chunker 版本、overlap 参数和 embedding 模型名。少记录任意一项,升级切片策略后就会复用旧向量。
第二个难点是删除同步。只 upsert 新 chunk 会让旧 chunk 留在向量库里。Qdrant 的 point 由向量和可选 payload 组成,官方文档也说明相同 point id 的重复写入具备幂等覆盖语义。我的做法是把 doc_id、file_hash、chunk_hash、chunk_index、parser_version、chunker_version 都写进 payload,并给常用过滤字段建索引。这样可以按文档版本滚动对账,也能把消失的 chunk 标记为 tombstone。
解决思路
我把导入拆成两张账本。第一张是 file ledger,只关心路径、大小、mtime、raw_file_hash、上次解析状态和错误原因。第二张是 chunk ledger,只关心某个文档版本下的 chunk 列表、chunk_hash、point_id、embedding 状态和删除状态。扫描文件时先查 file ledger,只有 raw_file_hash 变化才进入解析。解析完成后生成新的 chunk 列表,再和 chunk ledger 做 diff。
diff 的结果只分三类:未变化的 chunk 直接复用 point_id,新增或变化的 chunk 进入 embedding 队列,旧版本存在但新版本消失的 chunk 进入删除或 tombstone 队列。这样导入任务的成本和真实改动量相关,失败后也能从账本恢复,不会靠一次性内存状态猜测进度。
关键步骤
第一步,hash 放在靠近数据来源的位置。Node.js 的 crypto.Hash 可以用 stream 写入并产出 digest,适合主进程处理本地大文件。Web 侧的 SubtleCrypto.digest() 也能算摘要,但 MDN 明确提醒它不支持 streaming input,需要先把完整数据读入内存,所以我只把它用于小文件或浏览器侧预校验。
第二步,chunk hash 在文本规范化之后计算。我会去掉不稳定空白、统一换行、保留标题层级,再把 chunker 配置和 embedding 模型写进 hash 输入。第三步,point_id 采用稳定规则,例如 doc_id + chunk_hash。Qdrant 文档里 payload filtering 支持按 payload 和 id 加条件,适合做版本过滤和局部对账。第四步,embedding 队列只消费 changed chunks,并把每次写入的状态回填到 chunk ledger。
可复用经验
这套做法最大的收益是可解释。用户问为什么这次导入只跑了 37 个片段时,我可以从账本里看到哪些文件变了,哪些 chunk 命中缓存,哪些 point 被删除。排障时也能快速判断问题在文件扫描、解析、切片、embedding 还是向量库写入。
我现在会把增量导入的检查清单固定成五项:文件变化看 raw_file_hash,解析变化看 parser_version,切片变化看 chunker_version,向量复用看 chunk_hash,检索过滤看 payload index。RAG 的稳定性很多时候来自这些朴素账本,模型能力只是最后一层。