
给 AI 工具原型找后端时,我会先用 PocketBase 把边界跑通
很多 AI 工具原型一开始只有三件事:一个前端界面,一组用户会话,一些文件或任务状态。团队常常为了这些基础能力过早拉起完整后端,结果 Auth、CRUD、Realtime、文件上传、管理后台和部署脚本都要一起维护。PocketBase 的价值在这里很清楚:它把嵌入式 SQLite、实时订阅、内置认证、Dashboard UI 和 REST API 收进一个开源可执行文件里,适合先把数据边界跑通,再决定是否拆成更重的服务。
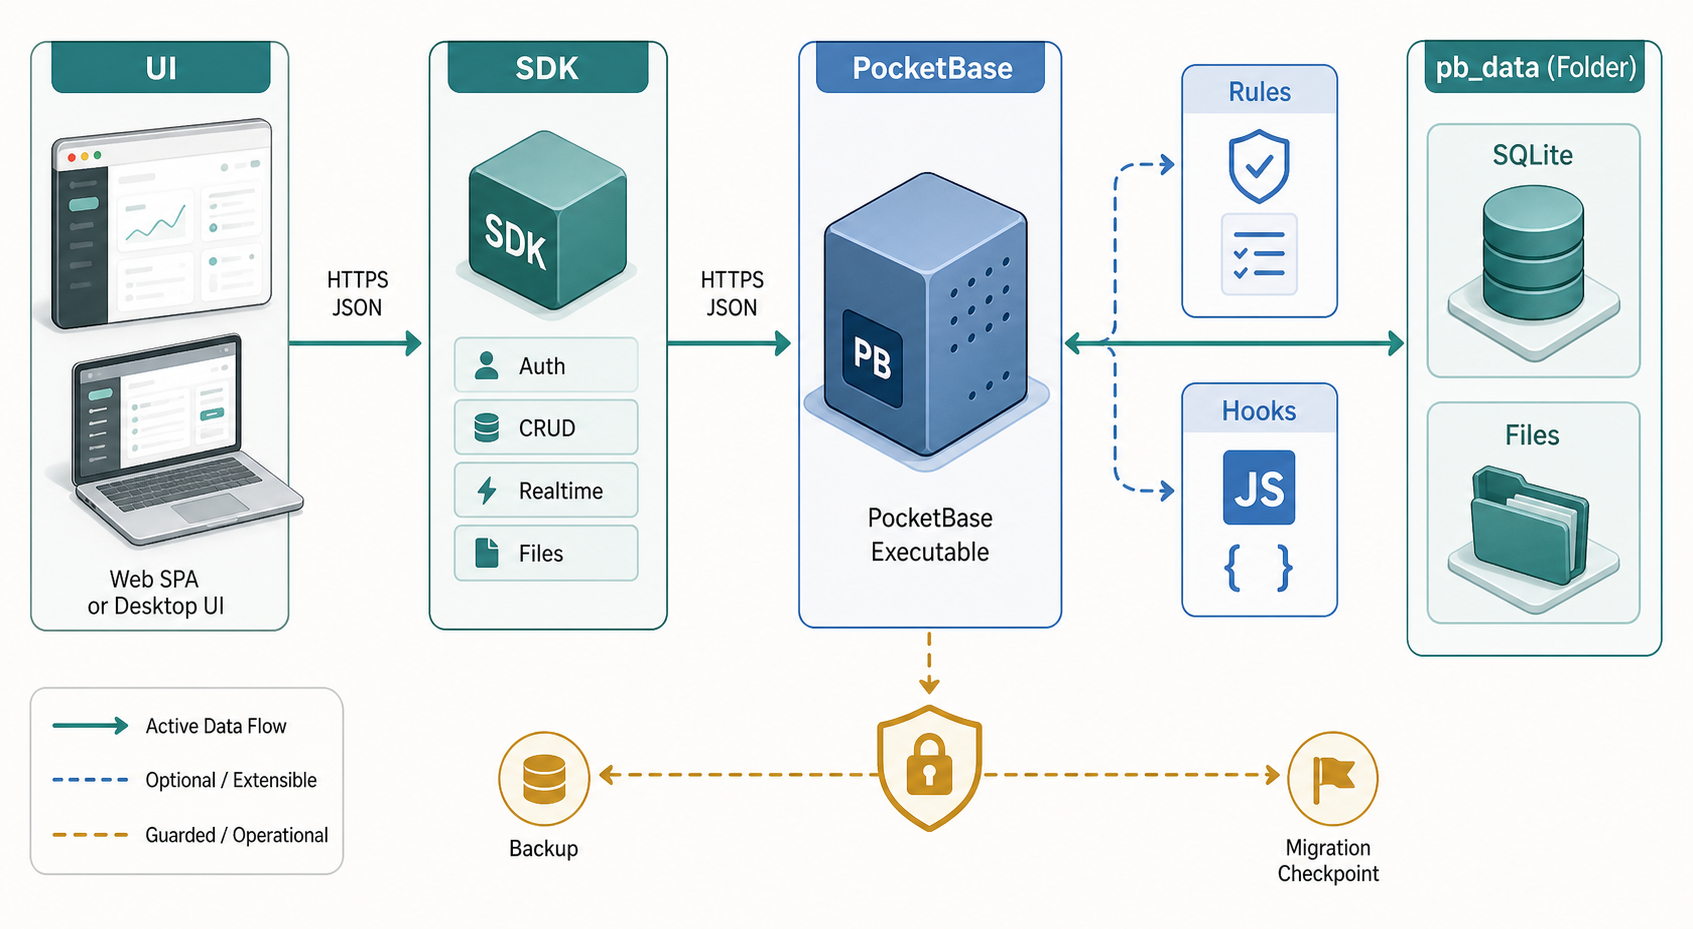
原创示意图:UI 通过官方 SDK 访问 PocketBase,可把 Auth、CRUD、Realtime、文件、Rules、Hooks 和 pb_data 备份边界先画清楚。 来源:Codex image generation
适合先验证什么
我会把 PocketBase 用在低风险的 AI 工具试验,比如提示词模板库、内部文件标注台、RAG 导入任务面板、Agent 运行记录和小型协作表单。官方文档说明,解压预编译程序后运行 ./pocketbase serve 就能启动服务,默认提供静态资源入口、超级用户后台和 API 路由。对原型团队来说,这意味着第一天可以先建 collections、配置 API rules、接前端 SDK,而无需先设计一整套用户和权限服务。
数据边界要提前画清楚
我不会把它当作可以无限扩张的生产中台。更稳的做法是先把 collections 分成四类:用户可编辑内容、AI 生成结果、任务运行状态和文件元数据。真实文件走 PocketBase 的 file 字段或外部对象存储,向量索引和模型调用日志只保存引用、hash、状态和可追溯摘要。这样以后从 PocketBase 迁到 Postgres、对象存储或专门的队列时,业务字段不会被临时实现绑死。
权限也要从原型期就写成规则。PocketBase 官方建议通过 collection API rules 控制数据访问,前端可以使用官方 JavaScript SDK 直接调用 Web API。我的习惯是每张表至少写清楚 list、view、create、update、delete 五个规则,管理脚本需要超级用户权限时只放在服务端动作里,浏览器端不持有高权限 token。
扩展点要保守使用
PocketBase 可以作为独立应用,也能通过 Go 或 JavaScript 扩展。官方 JS 文档提到,预编译程序内置 goja 引擎,可以在 pb_hooks 目录里写服务端 Hook 和路由。这个能力适合补少量校验、事件记录、Webhook 和后台任务入口。不要把复杂业务全塞进 Hook。AI 工具里真正重的部分,比如批量解析、向量化、长任务重试和模型调用,仍应放进单独 worker,只把状态回写到 PocketBase。
上线前的护栏
最容易被忽略的是升级和备份。PocketBase 官方文档明确提醒,v1 之前不保证完整向后兼容,也不推荐用于生产关键应用,除非团队愿意阅读 changelog 并处理手动迁移。预编译程序会在同目录管理 pb_data 和 pb_migrations,前者存放应用数据和上传文件,通常应进入备份策略,后者保存 collection 迁移文件,可以提交到仓库。
我的落地清单很短:原型期先建最小 schema,所有字段改动生成迁移;每次发布前备份 pb_data;高权限 token 只存在服务端;AI 长任务用独立 worker 执行;前端只通过 SDK 访问受规则保护的数据。这样 PocketBase 就能承担一个清晰角色:帮助团队快速验证工具的数据模型和交互闭环,同时保留未来拆分服务的退路。