
给 Agent 工具输出加 JSON Schema 验收门时,我会先把 unknown 和 Typed State 分开
最近整理一个前端 Agent 工具链时,我又踩到一个老问题:工具函数的 TypeScript 类型写得很漂亮,真实运行时却可能返回半截 JSON、多一个字段、少一个枚举值,或者把数字写成字符串。只要这类数据直接进入组件状态,后面看到的错误就会很散,列表渲染失败、重试误判、Electron 主进程和 Web 侧解释不一致都会冒出来。
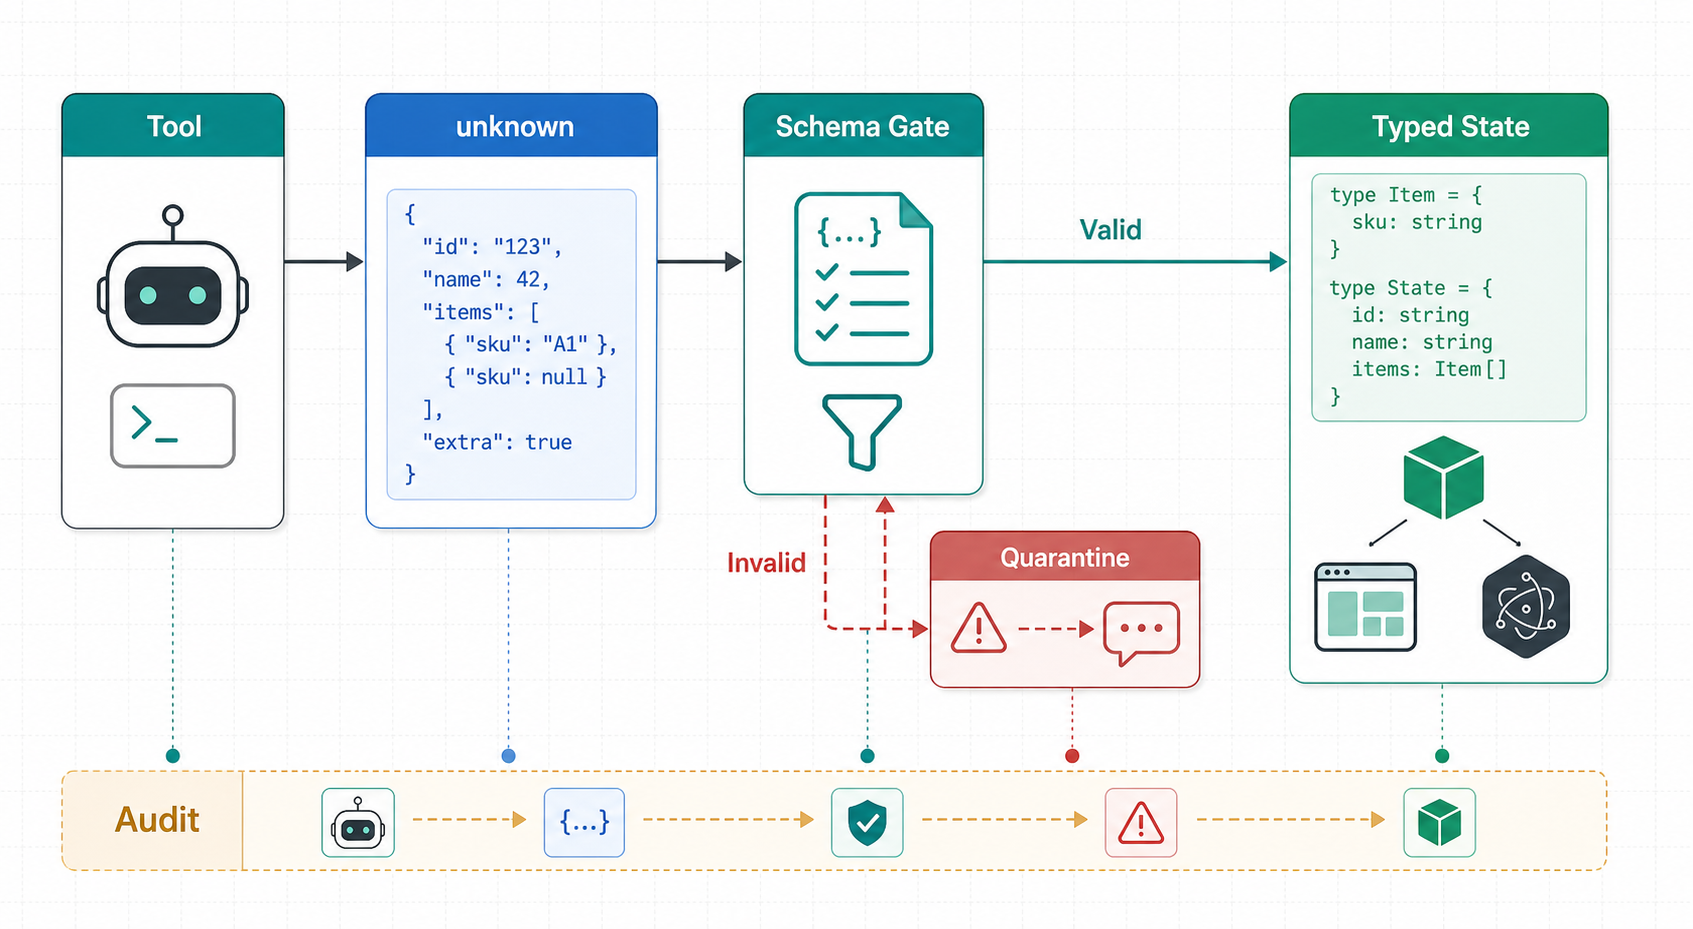
原创示意图:工具输出先按 unknown 入账,经过 Schema Gate 校验后分流到 Typed State 或 Quarantine,并在 Audit 账本中留下排障依据。 来源:Codex image generation
问题背景
最早我把工具返回值写成泛型,例如 runTool<T>(),调用侧拿到结果后就当成 T 使用。这个写法在 IDE 里顺手,但它约束的是代码内部协作,约束不了模型和外部工具的真实输出。TypeScript 文档里讲类型收窄时强调控制流和类型保护;对来自网络、模型或插件进程的数据,我现在都会先按 unknown 入账。
JSON Schema 正好适合做这道运行时验收门。它用 JSON 结构描述 JSON 数据本身,可以把 required、类型、数组元素、枚举和额外字段策略写成可检查契约。Ajv 会把 schema 编译成 JavaScript 校验函数,放在前端、Node 服务或 Electron 主进程边界都比较自然。
踩坑和关键难点
第一个坑是把 schema 当接口文档看。接口文档可以含糊一点,运行时 schema 需要更硬,比如 confidence 到底是 0 到 1 的 number,还是展示用百分比字符串,必须提前定清楚。
第二个坑是只处理成功路径。校验失败时也要留下原始 payload 的脱敏版本、schema 版本、错误列表、tool name 和 run id。这样重试时可以把具体错误反馈给 Agent,排障时也能判断问题在 prompt、工具适配层,还是上游字段漂移。
解决思路
我现在会把 runTool 的返回值固定成一个信封:raw 保存原始数据,validation 保存 schema 名称、版本和错误摘要,data 只有在校验成功后才出现。调用侧不能绕过 gate 直接消费 raw。如果失败,结果进入 quarantine 队列,并生成一条短修复提示,例如缺少 items[0].sku、status 不在枚举内、发现未声明的 extra 字段。
这个 gate 还有一个收益:组件只处理 Typed State,不用在每个渲染分支里猜字段是否存在。TypeScript 侧可以用类型谓词或封装好的 parseToolResult() 收窄类型,业务代码只面对 ok、invalid、retrying 这些明确状态。
关键步骤
第一步,所有外部工具输出先声明为 unknown。第二步,为每类工具输出写 schema,并给 schema 加版本号。第三步,校验失败时写审计账本,账本里保留脱敏 payload 和 Ajv 错误列表。第四步,把错误转成可读的修复提示,再交给 Agent 重试或人工复核。第五步,只有通过 gate 的数据才进入缓存、Redux store、TanStack Query 或 Electron IPC 响应。
我还会给 schema 加最小回归样本:一个完整成功样本、一个缺字段样本、一个类型错样本、一个额外字段样本。prompt 改动、工具升级或 schema 演进时,先跑样本集,再进入真实工作流。
可复用经验
Agent 工具链越长,越需要把不可信边界变成可观测边界。我的固定检查清单是四项:入口按 unknown 入账,schema 靠近边界层,失败结果进入隔离队列,成功结果再收敛成业务状态。出问题时,拿着 run id、schema version 和错误列表定位,比在组件栈里猜数据从哪一步变形要快很多。