
GitHub Models 退役后,我会先给 AI 原型补一层 provider 边界
7 月底再回头看 GitHub Models,最值得记住的信息已经从免费额度和模型清单,转向一个工程提醒:AI 原型里直接绑定某个托管模型入口,会在服务调整时把产品节奏、CI 流水线和评测脚本一起拖住。GitHub Docs 写得很明确,截至 2026 年 7 月 30 日,GitHub Models 的 playground、model catalog、inference API 和 BYOK 都已不可用。对还在做 AI 工具原型的小团队来说,这件事更适合被当成一次架构复盘。
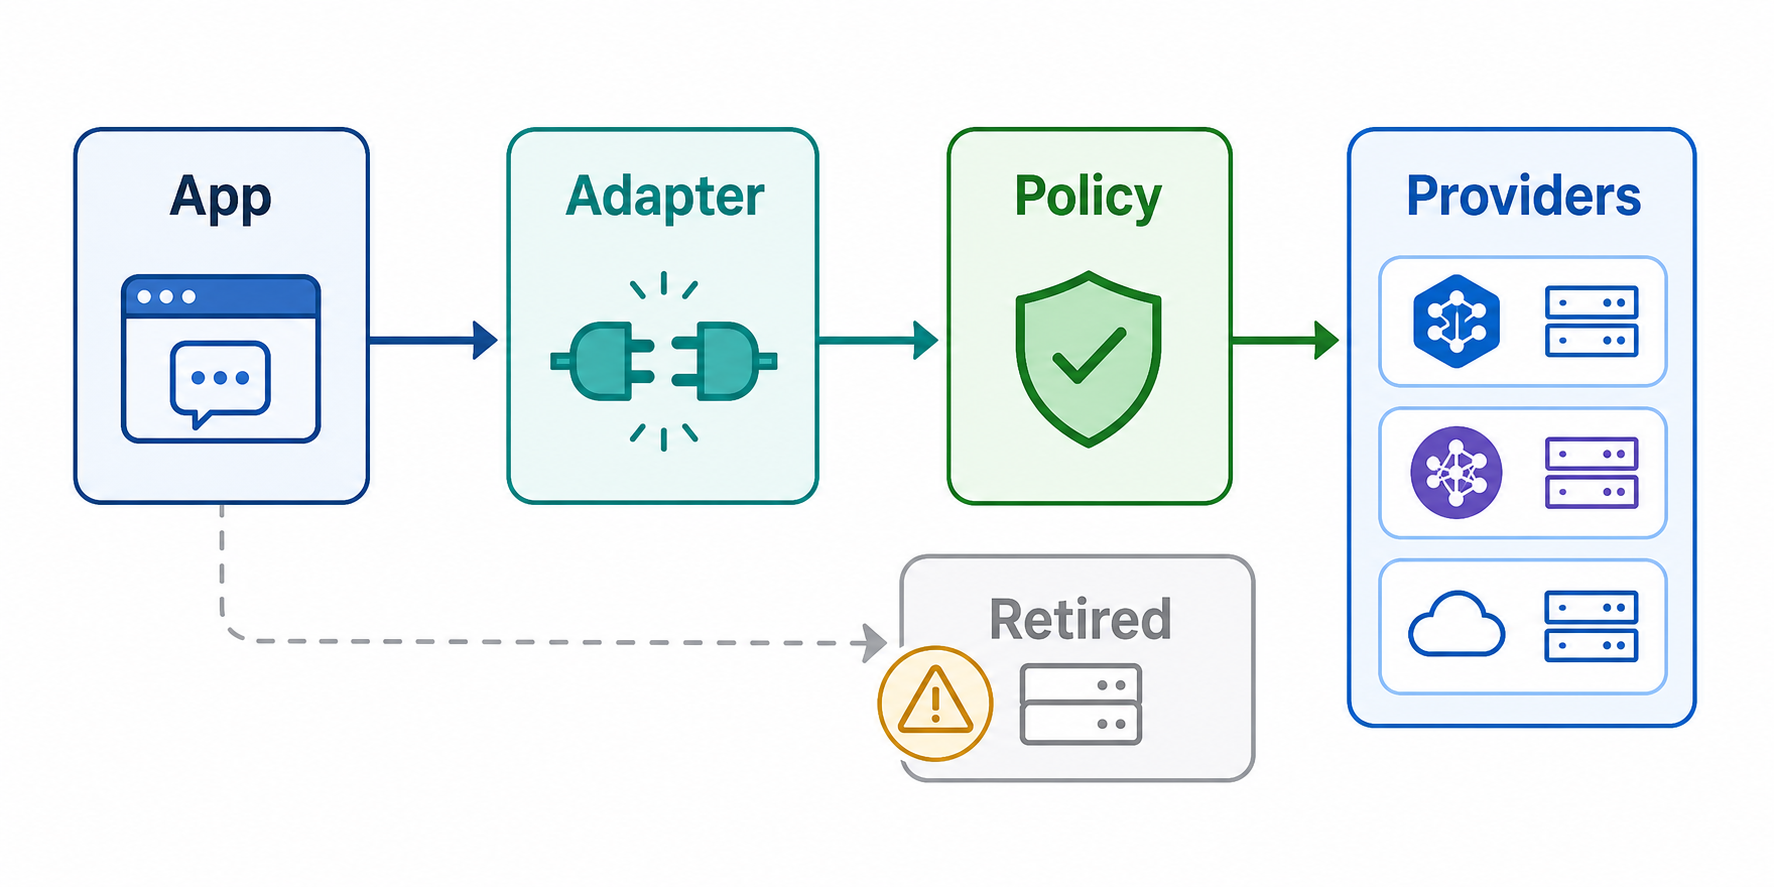
应用层通过 Adapter 和 Policy 再访问候选 Providers,退役入口从主路径中移除。 来源:Codex image generation
先把服务退役当成常态
模型服务和开发者平台的生命周期会比业务代码更快。今天可用的 playground、API endpoint、模型别名、上下文长度、速率限制和计费入口,明天都可能调整。原型阶段如果把入口、模型 ID、重试策略和提示词模板写在同一处,短期跑得很快,后面迁移时会很难判断到底是 provider 变了、模型能力变了,还是业务 prompt 本身不稳定。
我会把模型调用拆成四层:应用层只提交任务意图和输入;adapter 层把内部请求翻译成具体 provider 的参数;policy 层处理模型选择、预算、超时、日志脱敏和降级;provider 层再接 Azure AI Foundry、GitHub Copilot 相关工作流或其他正式模型服务。这样即使某个入口退役,应用层也只看到一次 provider 状态变化。
新原型要补三张表
第一张是 provider 清单,记录服务状态、认证方式、模型别名、区域、计费主体和数据保留要求。GitHub 的退役说明也给了下一步方向:需要模型访问的项目可以看 Microsoft Foundry 的模型目录,直接在 GitHub 内构建 AI workflow 则应看 Copilot 体系。这里不要只写“可用”,要写清楚谁负责账号、谁看账单、谁能申请 quota。
第二张是能力矩阵,把 chat、embedding、vision、tool calling、JSON 输出、长上下文和批处理分开。很多迁移失败来自调用方默认某个模型一定支持结构化输出或长上下文。把能力矩阵放进仓库,评测脚本就能按能力跳过不适合的 provider。
第三张是回归样本。每次换模型或换 provider,只跑 20 到 50 条高价值样本,比临时人工点 playground 更可靠。样本里要覆盖正常输入、长文本、空结果、敏感字段、超时和格式错误。CI 可以先给出离线报告,发布前再用受控 token 跑一轮线上冒烟。
迁移时别急着重写功能
如果项目曾经依赖 GitHub Models,第一步应是冻结旧接口调用,把失败状态转成清楚的内部错误码,例如 provider_retired、model_unavailable、quota_blocked。第二步再接入新的 adapter,并让同一批回归样本同时跑旧快照和新 provider。第三步才是调 prompt、调温度、调输出格式。
这套做法看起来比直接换 SDK 慢一点,但它能把“平台退役”从突发事故变成普通维护任务。以后再遇到模型下线、区域不可用、价格变化或组织策略收紧,团队只需要改 provider 配置、能力矩阵和少量 adapter 代码,应用层的任务流还能保持稳定。