
给 Worker 项目接 SQLite 数据库时,我会先用 Cloudflare D1 跑本地闭环
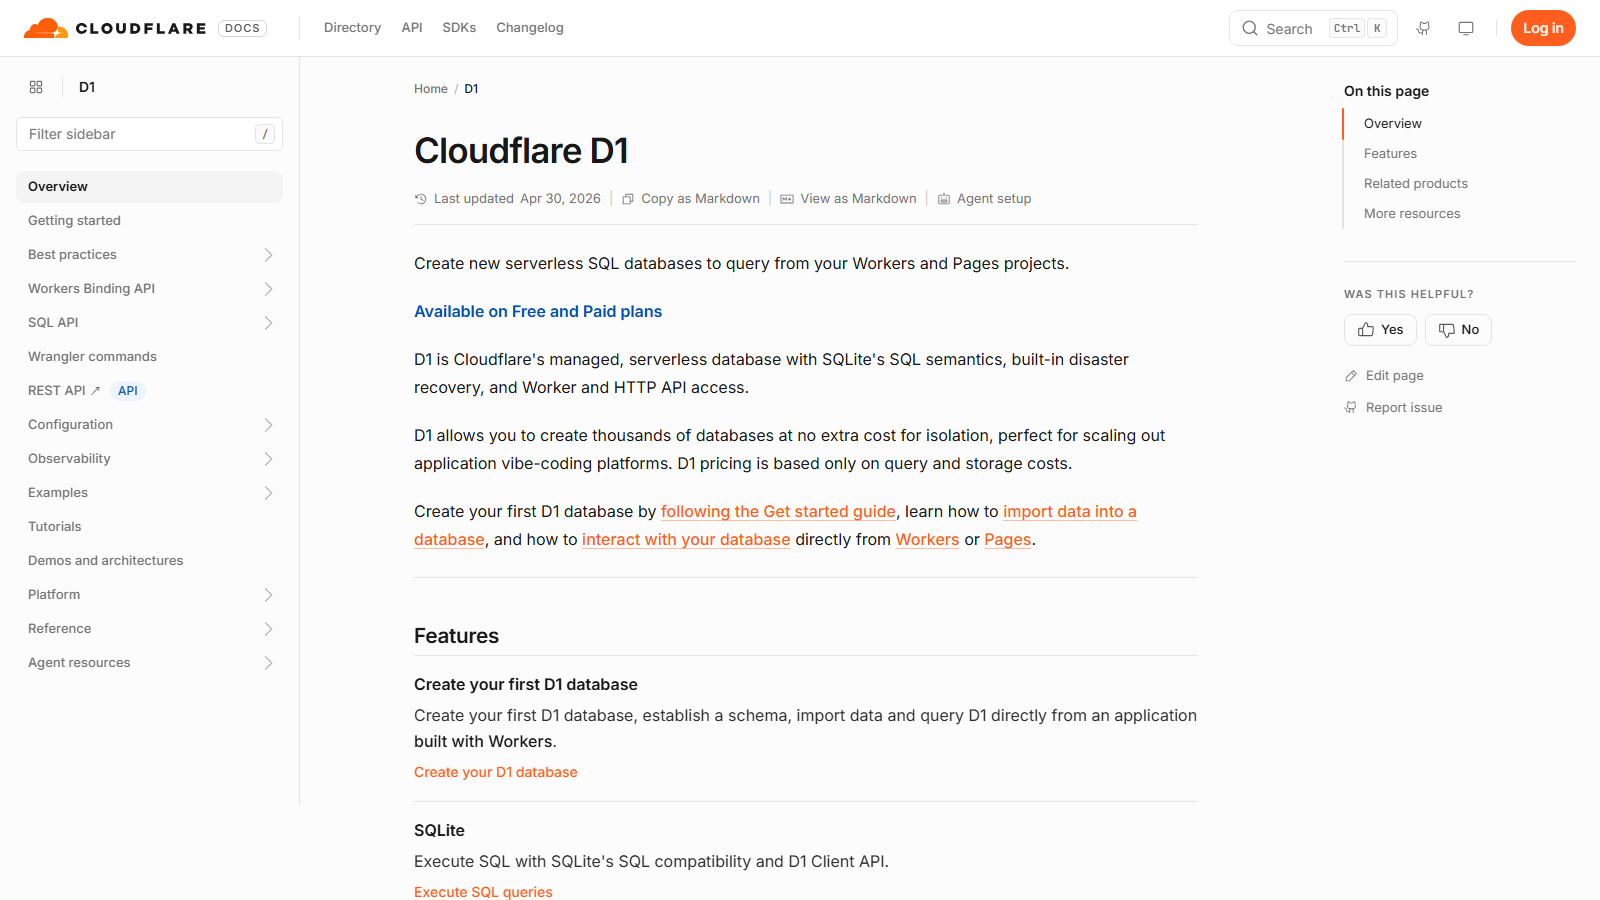
如果一个 Worker 项目只需要轻量关系型数据,先接 Cloudflare D1 往往比单独维护数据库实例更省心。D1 是 Cloudflare 管理的 serverless SQL 数据库,采用 SQLite 的 SQL 语义,可以从 Workers、Pages 或 HTTP API 查询。官方文档也明确标出它同时出现在 Free 和 Paid plans 中,这让小工具、演示项目和早期产品能先把数据路径跑通,再考虑访问量和存储预算。
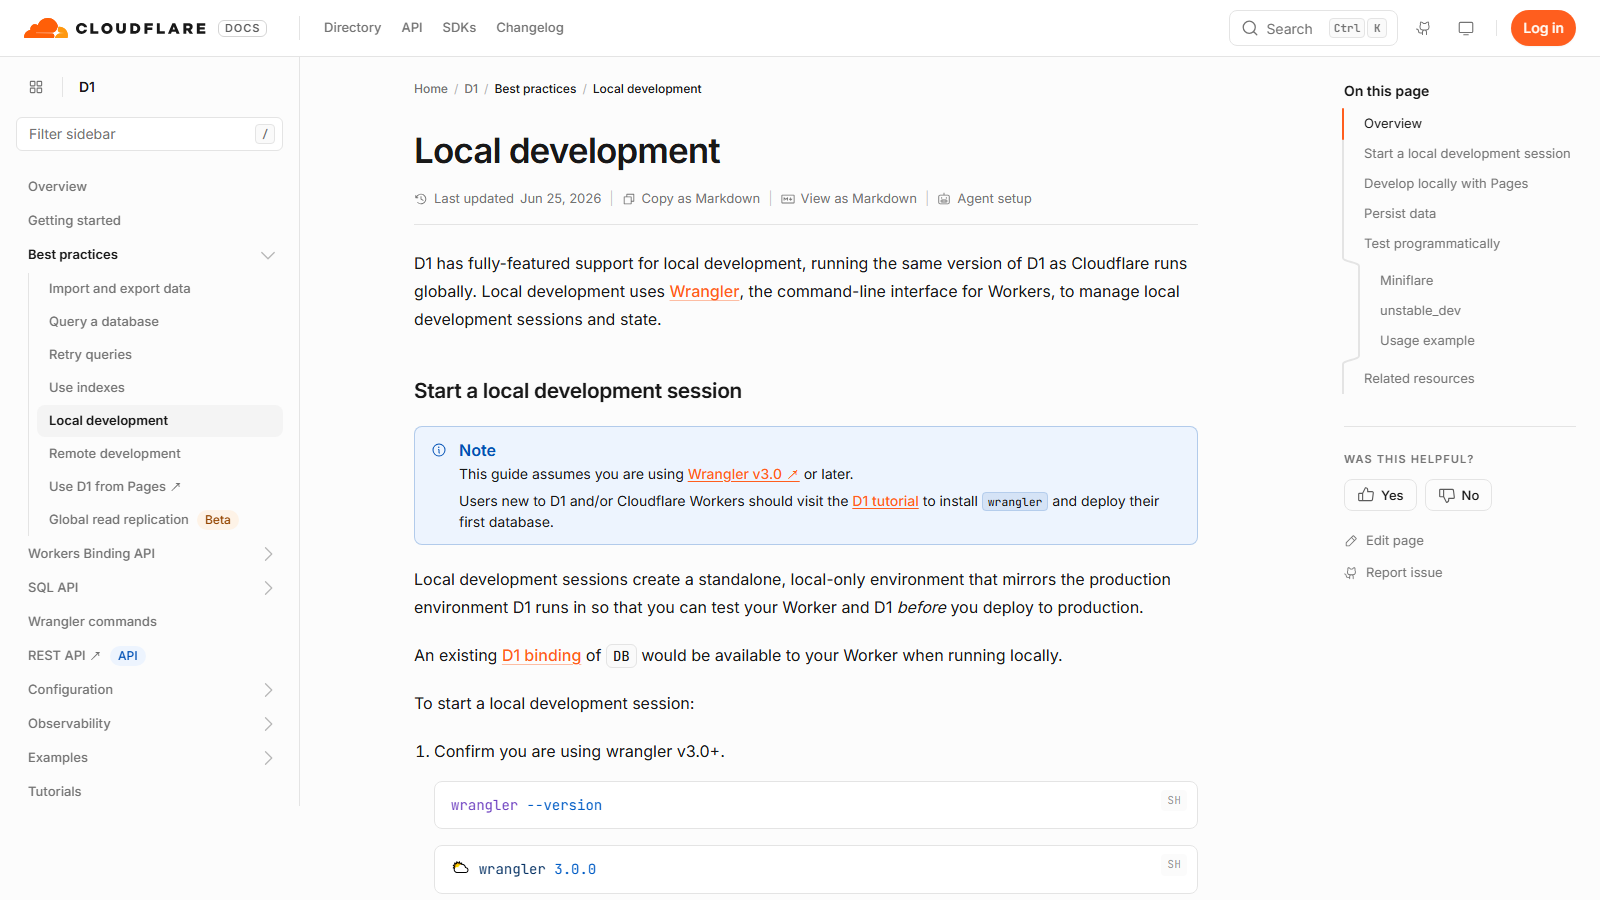
Cloudflare D1 本地开发文档截图,展示 Wrangler 本地会话和生产前测试边界。 来源:https://developers.cloudflare.com/d1/best-practices/local-development/ ,cloudflare/cloudflare-docs 采用 CC BY 4.0:https://raw.githubusercontent.com/cloudflare/cloudflare-docs/production/LICENSE
我会先隔离本地和远端
D1 最值得提前想清的是环境边界。官方本地开发文档说明,Wrangler 的本地会话会创建一个独立的 local only 环境,用来模拟生产 D1 的运行方式。换句话说,默认本地调试不会直接读写生产数据,这对调试表结构和接口逻辑很重要。
我会先确认团队使用的是 Wrangler v3 或更高版本,然后把绑定写在配置里,让 Worker 代码始终通过同一个 DB binding 访问数据库。Pages 加 D1 的本地开发还会用到 preview_database_id,这个字段适合明确写进示例配置,避免新人只看 database_id 就误以为本地和生产共享一份状态。
wrangler --version
wrangler dev
只有在需要真实数据排查时,才考虑把绑定设置为 remote = true。这个开关应该进入变更记录或排障单,因为远端写操作没有本地回滚的余地。
迁移文件要进入版本库
关系型数据库最怕手工改表后没人知道。D1 的 migrations 文档围绕 migrations_dir、migrations_table 和 migrations_pattern 组织迁移文件,适合把表结构变更纳入代码评审。我的习惯是把第一版 schema 写成迁移,再用本地库跑一次接口用例,确认查询、索引和默认值符合预期。
wrangler d1 migrations create DB init
wrangler d1 migrations apply DB --local
如果项目使用 Drizzle 这类 ORM,迁移文件可能被放进多级目录,文档里提到可以用 glob pattern 匹配这类布局。这里的重点在于让数据库状态有来源、有顺序、有复盘方式,命令只是执行入口。
适合的使用场景
D1 适合读多写少、小型配置、用户偏好、内容索引、队列状态表和边缘应用的轻量后台。它不适合直接承接复杂事务型核心库,也不该用本地模拟结果替代生产压测。对 CorianderLab 这类小型工具站,我会先用 D1 把 Workers API、迁移、种子数据和本地测试打通,等产品形态稳定后,再决定是否需要更强的数据库方案。
来源链接
- Cloudflare D1 官方文档:https://developers.cloudflare.com/d1/
- D1 Local development:https://developers.cloudflare.com/d1/best-practices/local-development/
- D1 Migrations:https://developers.cloudflare.com/d1/reference/migrations/
- Cloudflare Docs GitHub 仓库:https://github.com/cloudflare/cloudflare-docs
- Cloudflare Docs CC BY 4.0 License:https://raw.githubusercontent.com/cloudflare/cloudflare-docs/production/LICENSE